 点森科技 - 科技资讯_数码产品_互联网观察_智能硬件

前言
在上一篇文章《》实测了 PP-OCRv5 传统 OCR 在鲲鹏 CPU 上的整页识别性能。本文延续这条实践路线,聚焦 PaddleOCR 家族的新成员——PaddleOCR-VL-1.6。
PaddleOCR-VL-1.6 是一款参数量约 0.9B(9 亿)的视觉语言模型,采用「整页理解、直接生成」的自回归解码路线:输入整页图片,直接输出 Markdown 结构化文本。该方案与传统 OCR 的检测、识别分阶段流程形成互补,适用于复杂文档结构理解等场景。
OpenAtom openEuler(简称:”openEuler”或”开源欧拉”)为这条新产线提供了从鲲鹏 CPU 到昇腾 NPU 的异构部署基础:CPU 侧可通过 vLLM CPU 后端拉起模型,NPU 侧可借助 vLLM + vllm-ascend 在昇腾 910B4 上运行。
本文不再展开 PaddleOCR、vLLM、vllm-ascend 等基础环境的安装过程,而是将重点放在 PaddleOCR-VL-1.6 的部署验证、推理过程以及性能数据上。相关环境准备和安装配置,可参考文末附带的官方教程。需要说明的是,本文数据均来自特定软硬件环境和测试参数,主要用于记录本次实践中 PaddleOCR-VL-1.6 的实际运行表现。测试结果仅反映本文所采用的软硬件组合及配置条件,不作为 CPU 与 NPU 通用性能的横向对比结论。
一、PaddleOCR-VL-1.6 与测试路线
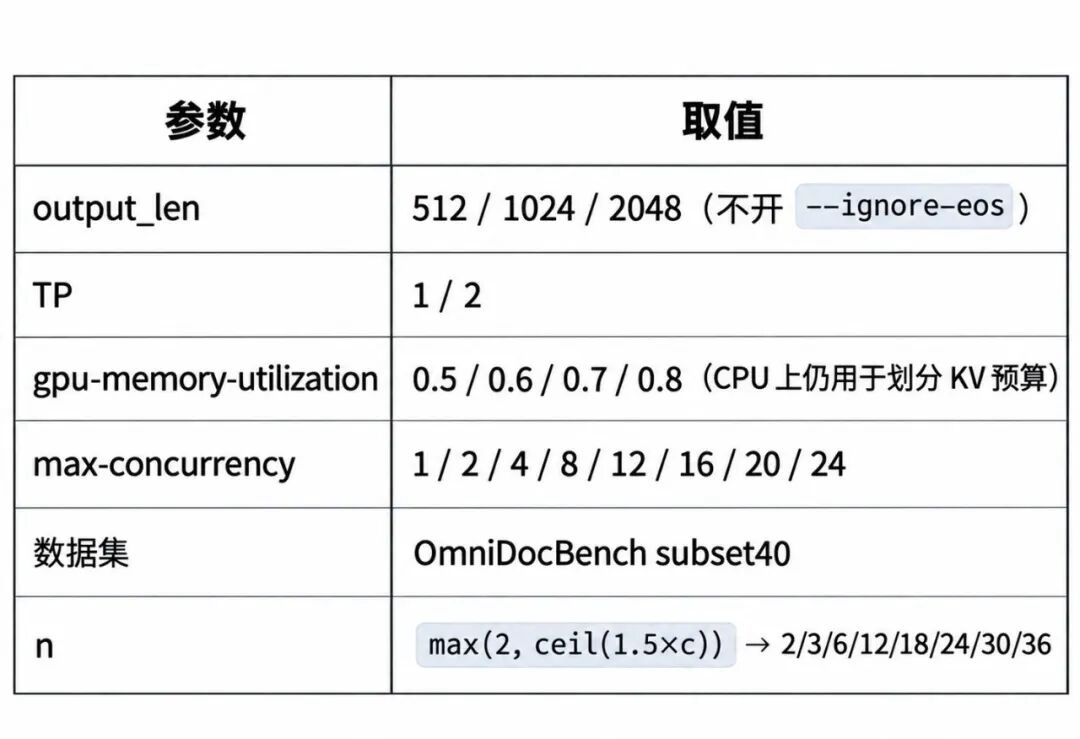
本文围绕五个变量展开测试,各变量的预期作用与说明如下:

二、环境准备
▐ 2.1 环境与版本
本文使用 openEuler 容器环境进行测试,宿主机与容器的主要组件版本如下:
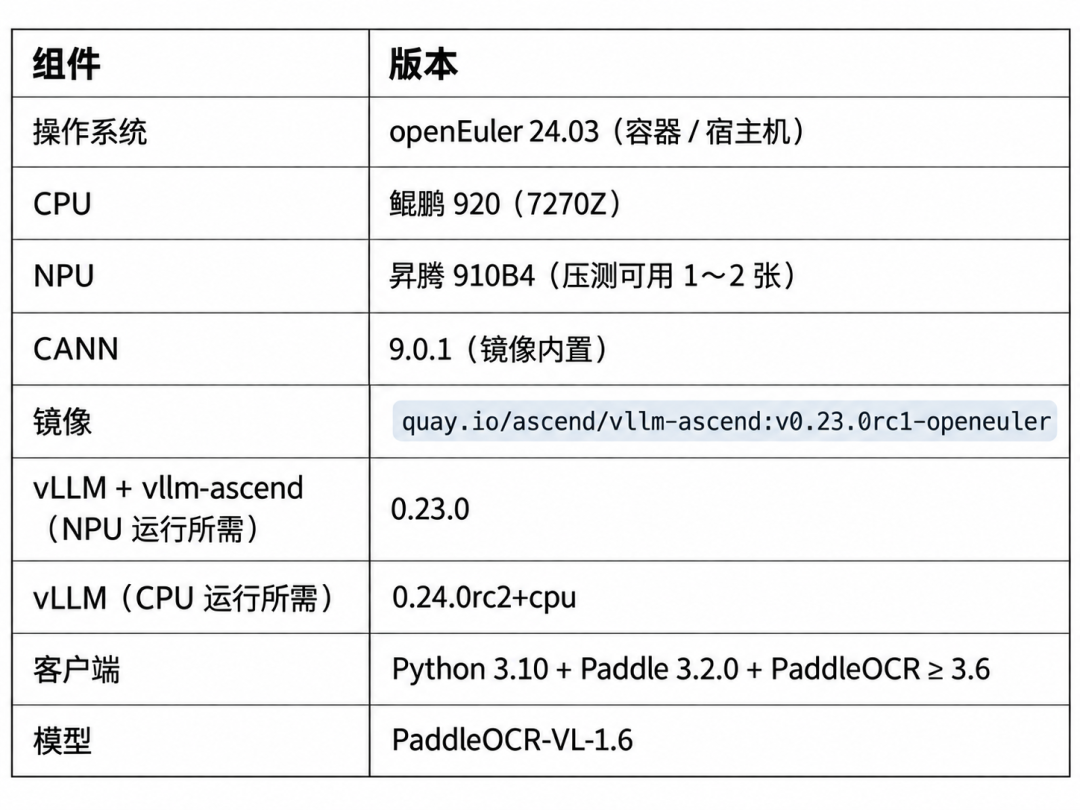
▐ 2.2 启动容器
docker run --name=paddle-ocr-test \--volume /root/.cache:/root/.cache \--volume /home:/home \--volume /usr/local/dcmi:/usr/local/dcmi \--volume /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \--volume /usr/local/Ascend/driver/lib64:/usr/local/Ascend/driver/lib64 \--volume /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \--volume /etc/ascend_install.info:/etc/ascend_install.info \--privileged \--workdir=/paddle_ocr \--device /dev/devmm_svm:/dev/devmm_svm \--device /dev/hisi_hdc:/dev/hisi_hdc \--device /dev/davinci_manager:/dev/davinci_manager \--device /dev/davinci2:/dev/davinci2 \--runtime=runc \-it -d \quay.io/ascend/vllm-ascend:v0.23.0rc1-openeuler \bash
三、PaddleOCR-VL-1.6 服务搭建
▐ 3.1 CPU 侧拉起 VL
CPU 侧使用 vLLM CPU 后端,无需加载 vllm-ascend。此版本 vLLM 不使用 –device cpu,而是通过 VLLM_TARGET_DEVICE=cpu 指定运行设备。
容器内执行:
export VLLM_TARGET_DEVICE=cpuexport VLLM_PLUGINS=""export OMP_NUM_THREADS="$OMP_NUM_THREADS"export LD_PRELOAD="${LD_PRELOAD:-}"export PYTHONNOUSERSITE=1export PYTHONPATH=vllm serve /models/PaddleOCR-VL-1.6 --host 0.0.0.0 --port 8200 --enforce-eager --tensor-parallel-size 1 --max-num-seqs 2 --max-num-batched-tokens 2048 --max-model-len 8192 --limit-mm-per-prompt '{"image":1}' --served-model-name PaddleOCR-VL-1.6 --trust-remote-code --no-enable-prefix-caching --mm-processor-cache-gb 0 --gpu-memory-utilization 0.6 --dtype bfloat16
默认端口 8200。
▐ 3.2 NPU 侧拉起 VL
容器内执行:
export PATH=/usr/local/python3.12.13/bin:$PATHexport ASCEND_RT_VISIBLE_DEVICES=0export TASK_QUEUE_ENABLE=1export CPU_AFFINITY_CONF=1export PYTORCH_NPU_ALLOC_CONF="expandable_segments:True"vllm serve /models/PaddleOCR-VL-1.6 \--host 0.0.0.0 --port 8000 \--tensor-parallel-size 1 \--max-num-batched-tokens 16384 \--served-model-name PaddleOCR-VL-1.6 \--trust-remote-code \--no-enable-prefix-caching \--mm-processor-cache-gb 0 \--gpu-memory-utilization 0.6 \--compilation-config '{"cudagraph_mode":"FULL_DECODE_ONLY"}' \--additional_config '{"enable_cpu_binding":true}' \--max-num-seqs 32
双卡对照时改为 ASCEND_RT_VISIBLE_DEVICES=0,1,并追加 –tensor-parallel-size 2 –distributed-executor-backend mp(容器需映射两张卡)。
▐ 3.3 冒烟测试
用官方样例图走一遍「PaddleOCR 客户端 → vLLM VLM」链路。
source /paddle_ocr/.venv_client/bin/activateexport PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=Truepython << 'EOF'from paddleocr import PaddleOCRVLpipeline = PaddleOCRVL(pipeline_version="v1.6",vl_rec_backend="vllm-server",vl_rec_server_url="http://127.0.0.1:8000/v1", # 这里端口号根据实际情况调整vl_rec_api_model_name="PaddleOCR-VL-1.6",use_layout_detection=False,use_doc_orientation_classify=False,use_doc_unwarping=False,device="cpu",)output = pipeline.predict("/paddle_ocr/demo/paddleocr_vl_demo.png")for i, res in enumerate(output):res.print()res.save_to_json(save_path=f"/paddle_ocr/output_{i}.json")res.save_to_markdown(save_path=f"/paddle_ocr/output_{i}.md")print("SMOKE_OK")EOF
跑通标志:终端打印 SMOKE_OK,并生成 /paddle_ocr/output_0.md(整页识别结果的结构化文本)。CPU 与 NPU 两侧均以同样方式完成冒烟后再进入压测。
四、压测约定与指标口径
▐ 4.1 压测约定
-
数据集:统一使用 custom_image + jsonl,并从 OmniDocBench 全量 1651 页中抽取 40 页组成测试子集(prompt 为 OCR:),同时添加 –custom-ensure-client-side-data。
-
生成长度:不开 –ignore-eos,整页自然输出约 800~900 token,512 会截断,2048 基本能完整跑完。
-
请求规模:n = max(2, ceil(1.5 × c)),warmup 2 条,–request-rate inf。
-
tokenizer:–tokenizer 必须指向本地模型目录 /models/PaddleOCR-VL-1.6。
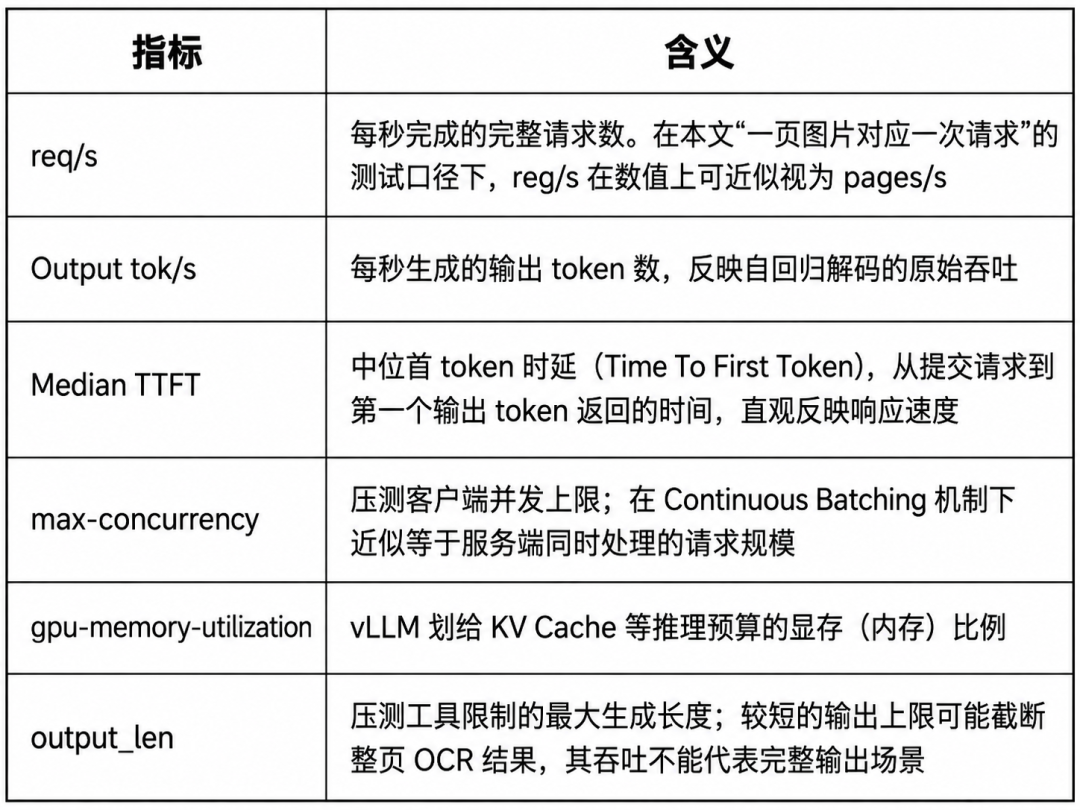
▐ 4.2 关键指标口径
五、CPU 上部署 PaddleOCR-VL-1.6
CPU 侧采用固定单进程配置,不启用张量并行。测试覆盖 3 档 olen × 3 档 gpu-memory-utilization × 8 档并发;gpu-memory-utilization=0.7 未纳入本轮有效结果。
测试矩阵:

olen=512

olen=1024

olen=2048

>>小结:
在本文测试配置下,gpu-memory-utilization=0.5 / 0.6 / 0.8 三档的结果接近,请求吞吐稳定在 0.02~0.03 req/s。随着并发提高,请求排队时间增加,而整体吞吐变化有限,说明该场景主要受到视觉编码与自回归解码计算量的影响,调整内存预算带来的收益不明显。整页 olen=2048、c=24 时约为 0.03 req/s · 25 tok/s · TTFT 228s。测试结果验证了 PaddleOCR-VL-1.6 在鲲鹏 CPU 环境中的兼容运行能力,可用于功能验证、轻量调用或其他非时延敏感场景。
六、NPU 上部署 PaddleOCR-VL-1.6
NPU 侧使用两张可用的昇腾 910B4 进行测试,服务通过 vLLM + vllm-ascend 部署。本文分别验证单卡 TP=1 和双卡 TP=2,并对 output_len、gpu-memory-utilization 与并发数进行组合测试。四项主要参数共形成 3 × 2 × 4 × 8 = 192 种组合,测试矩阵如下:
服务端固定:–max-num-seqs 32、–max-num-batched-tokens 16384、–distributed-executor-backend mp。
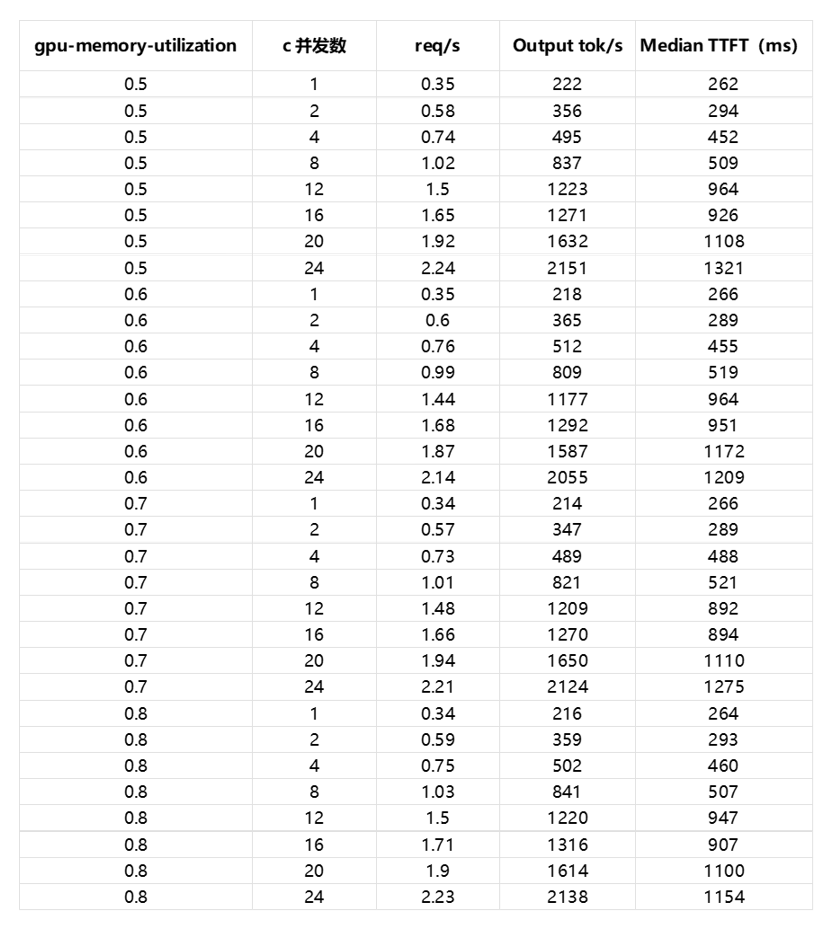
▐ 6.1 单卡 TP=1
olen=512

olen=1024

olen=2048
▐ 6.2 双卡 TP=2
olen=512

olen=1024

olen=2048

>>小结:
整页 olen=2048、c=24、TP=1 时约为 2.2 req/s · 2100 tok/s · TTFT 1.1~1.3s。在本文特定软硬件环境与参数配置下,NPU 路径展现出更适合视觉编码与自回归解码负载的并行计算能力,可为在线整页识别提供较好的吞吐与响应表现。
NPU 路径的吞吐主要随 max-concurrency 提高;gpu-memory-utilization=0.5~0.8 各档结果接近,说明对 0.9B 参数规模的 PaddleOCR-VL-1.6 而言,当前显存容量能够满足模型加载与测试需求。
在本文采用的 TP=2 配置下,同档整页 c=24 约为 1.6~1.7 req/s,TTFT 约为 2.2~3.1s,卡间通信与同步开销尚未转化为吞吐收益。因此,对该模型及本文测试负载而言,单卡配置具有更高的资源利用效率;双卡可进一步用于模型容量扩展、数据并行或多实例服务,具体方案仍需结合业务并发与部署架构评估。
七、总结与部署建议
以下结果均基于 OmniDocBench subset40。在本文“一页图片对应一次请求”的测试口径下,req/s 在数值上可近似视为 pages/s。CPU 与 NPU 路径使用各自适配的软件栈和服务参数,表格用于提供部署选型参考,不代表通用硬件能力对比:

说明: 表内取的是整页完整输出口径(olen=2048)下的最优 req/s。同配置 TP=1、c=24 时,olen=512 可到约 4.07 req/s,但短输出会截断整页 OCR;该结果仅反映截断输出场景,不纳入完整整页识别的部署对照。
本次测试验证了 PaddleOCR-VL-1.6 在 openEuler 24.03 上从鲲鹏 CPU 到昇腾 NPU 的完整部署链路。对于视觉语言模型的整页理解任务,昇腾 NPU 路径能够发挥并行计算优势;在仅有 CPU 资源或采用传统 OCR 流程时,PP-OCRv5 仍可提供适合相应场景的部署选择。实际落地时,建议结合识别精度、响应时延、并发规模与硬件资源综合选型。
参考链接
-
PaddleOCR 昇腾教程:
https://www.paddleocr.ai/latest/version3.x/pipeline_usage/PaddleOCR-VL-Huawei-Ascend-NPU.html
-
vLLM Ascend · PaddleOCR-VL:
https://docs.vllm.ai/projects/ascend/en/latest/tutorials/models/PaddleOCR-VL.html
-
PaddleOCR-VL-1.6 权重:
https://huggingface.co/PaddlePaddle/PaddleOCR-VL-1.6
-
OmniDocBench:
https://huggingface.co/datasets/opendatalab/OmniDocBench


本专项聚焦 openEuler 系统 AI 北向软件生态适配与性能优化,围绕大、中、小模型全场景推理、训练需求,完成 SGLang、Ollama、vLLM、PaddleOCR 等主流 AI 框架及工具链的适配兼容与性能调优,覆盖大模型推理加速、轻量化模型部署、向量语义编码、语义重排、多场景 OCR 识别等核心AI能力。专项打通系统层与 AI 应用框架的适配壁垒,解决 openEuler 环境下 AI 模型框架部署兼容差、运行低效、适配碎片化等问题,搭建标准化、高性能、全适配的北向 AI 软件栈,充分释放系统异构算力,为开发者提供开箱即用的大模型开发、微调与部署环境,完善从底层算力到上层 AI 应用的全链路生态支撑。
-END-
供稿 | 欧阳庆
编辑 | 丘云
校审 | 赵家麒、郑振宇、刘彦飞
往期推荐
关注我们,了解更多
▼